Automatización con n8n e IA: 7 lecciones de proyectos reales


Un cliente dedicaba unos 45 minutos cada mañana a revisar una veintena de medios financieros buscando noticias que afectaran a sus clientes. Ahora recibe un correo con la selección hecha. Otro tardaba unos diez minutos en preparar un envío de condiciones comerciales después de cada visita, aunque en la práctica lo iba posponiendo hasta que encontraba un hueco. Ahora el borrador le espera en Gmail.
Los dos procesos están construidos con n8n, y de ellos, junto con algún proyecto más, salen los aprendizajes de este artículo. Pero antes, un poco de contexto sobre la herramienta.
Qué es n8n y en qué se diferencia
n8n es una herramienta de automatización visual. Construyes flujos encadenando nodos: uno lanza el proceso, otro llama a una API, otro decide por dónde seguir, otro escribe en una hoja de cálculo. Hay nodos nativos para cientos de servicios y también para modelos de IA, bases de datos vectoriales y agentes.
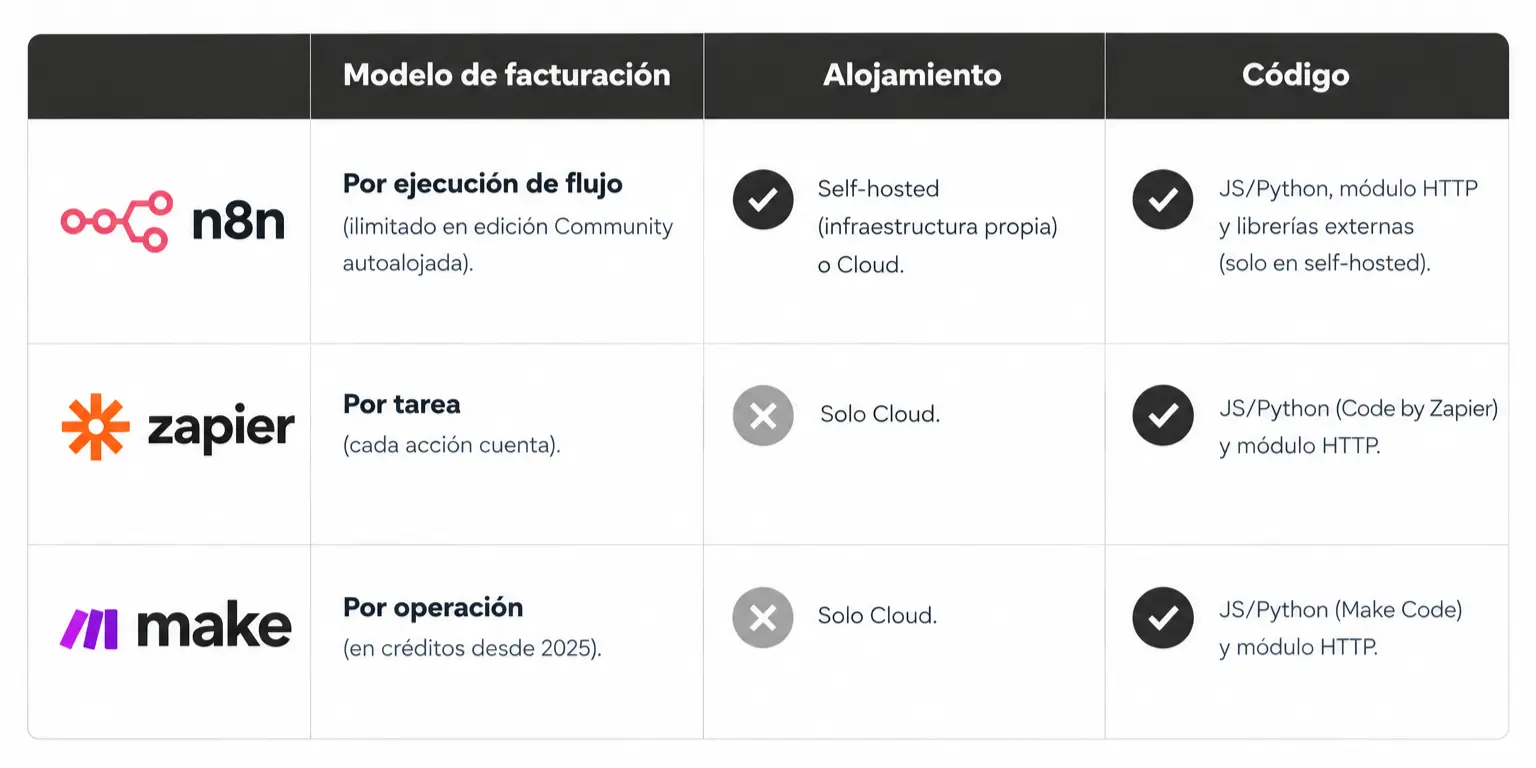
Hasta ahí se parece a Zapier o Make. Y conviene ser honesto con las diferencias, porque en las comparativas suelen exagerarse. Escribir código no es exclusivo de n8n: Zapier cuenta con Code by Zapier y Make con Make Code, ambos con JavaScript y Python. Las tres permiten además llamar a cualquier API con un módulo HTTP genérico.
Donde sí hay una diferencia categórica es en dos puntos:
El alojamiento. n8n permite la instalación en tu propia infraestructura (self-hosted). Ni Zapier ni Make ofrecen esa opción. Y eso también cambia lo que puedes hacer con código: en una instalación propia, el nodo de código puede usar librerías externas, algo que la versión en la nube de n8n no permite.
La facturación. Zapier cobra por tarea y Make por operación, es decir, por cada módulo que se ejecuta (desde 2025 lo contabiliza en créditos). Los planes de pago de n8n, en cambio, cuentan ejecuciones de flujo, independientemente de cuántos pasos tengan. Y la edición Community autoalojada no tiene límite de ejecuciones.
El resultado es algo intermedio entre una herramienta no-code y un pequeño backend. En la práctica, todos los flujos que hemos puesto en producción tienen nodos de código. No porque nos guste complicarlo, sino porque los casos reales siempre tienen una esquina que ningún nodo nativo cubre.
Cloud o autoalojado
Empezamos en n8n Cloud con el plan básico. Para validar una idea es la opción correcta: no mantienes nada, las actualizaciones y las credenciales OAuth vienen resueltas y en diez minutos tienes un flujo funcionando.
El límite llegó con el número de ejecuciones. Cuando ya tienes varias automatizaciones corriendo a diario, ese cupo se agota antes de lo que parece y toca subir de plan. Llegados a ese punto, con los procesos ya validados y en producción, movimos la infraestructura a una instancia propia.
La regla que sacaría de esto es sencilla. Cloud mientras estés comprobando si la automatización aporta, porque lo último que quieres en esa fase es pelearte con un servidor. Autoalojado cuando el volumen es estable, asumiendo que a partir de ahí las actualizaciones, las copias de seguridad y el tiempo de servicio pasan a ser responsabilidad tuya.
En Dreams aplicamos estos aprendizajes a nuestros proyectos de IA y automatización para empresas, diseñando soluciones a medida que integran n8n, inteligencia artificial y los sistemas existentes de cada organización. Además del desarrollo, ofrecemos infraestructura propia, monitorización y mantenimiento para garantizar su funcionamiento en producción.
1. Lo que más haces en n8n ocurre fuera de n8n
Un flujo casi nunca es "haz A". Lo habitual es algo como: cuando pase A en una herramienta, busca B en otra y, con las dos cosas, genera C en una tercera. El envío de condiciones comerciales, por ejemplo, parte de una reunión registrada en el CRM, busca las plantillas y tarifas en Google Drive y acaba creando un borrador en Gmail. Tres herramientas, tres formas distintas de hacer las cosas.
Por eso, la mayor parte del tiempo no lo pasas en n8n, sino en la documentación de las herramientas que conectas. En cada flujo aprendes una nueva: cómo organiza sus datos, qué permite su API y qué no, cuáles son sus límites.
Algunos ejemplos de lo que solo descubres leyendo la documentación. Un CRM no suele guardar los datos del cliente dentro de cada reunión, sino una referencia a la ficha del contacto y a la de su empresa, así que reunir la información completa supone varias consultas encadenadas. Cuando exportas un documento de Google Docs como HTML, no recibes solo el texto con su formato, sino una página completa con cabecera y estilos que hay que limpiar antes de usarla en un correo. Y casi todas las API limitan cuántas peticiones puedes hacer por minuto: si el flujo procesa muchos registros seguidos, toca dividirlos en lotes y añadir pausas entre ellos.
Y luego están las credenciales. Cada servicio tiene su propio sistema: tokens de aplicación privada, OAuth, claves de API, aplicaciones de desarrollador distintas para leer datos y para recibir eventos. A veces el bloqueo ni siquiera es técnico: si la cuenta pertenece a una organización, puede hacer falta que su administrador autorice el acceso antes de poder conectar nada.
Nada de esto aparece en el canvas, pero es lo que determina cuánto tarda de verdad un flujo en funcionar.
2. Cuando el nodo nativo no llega, está la API
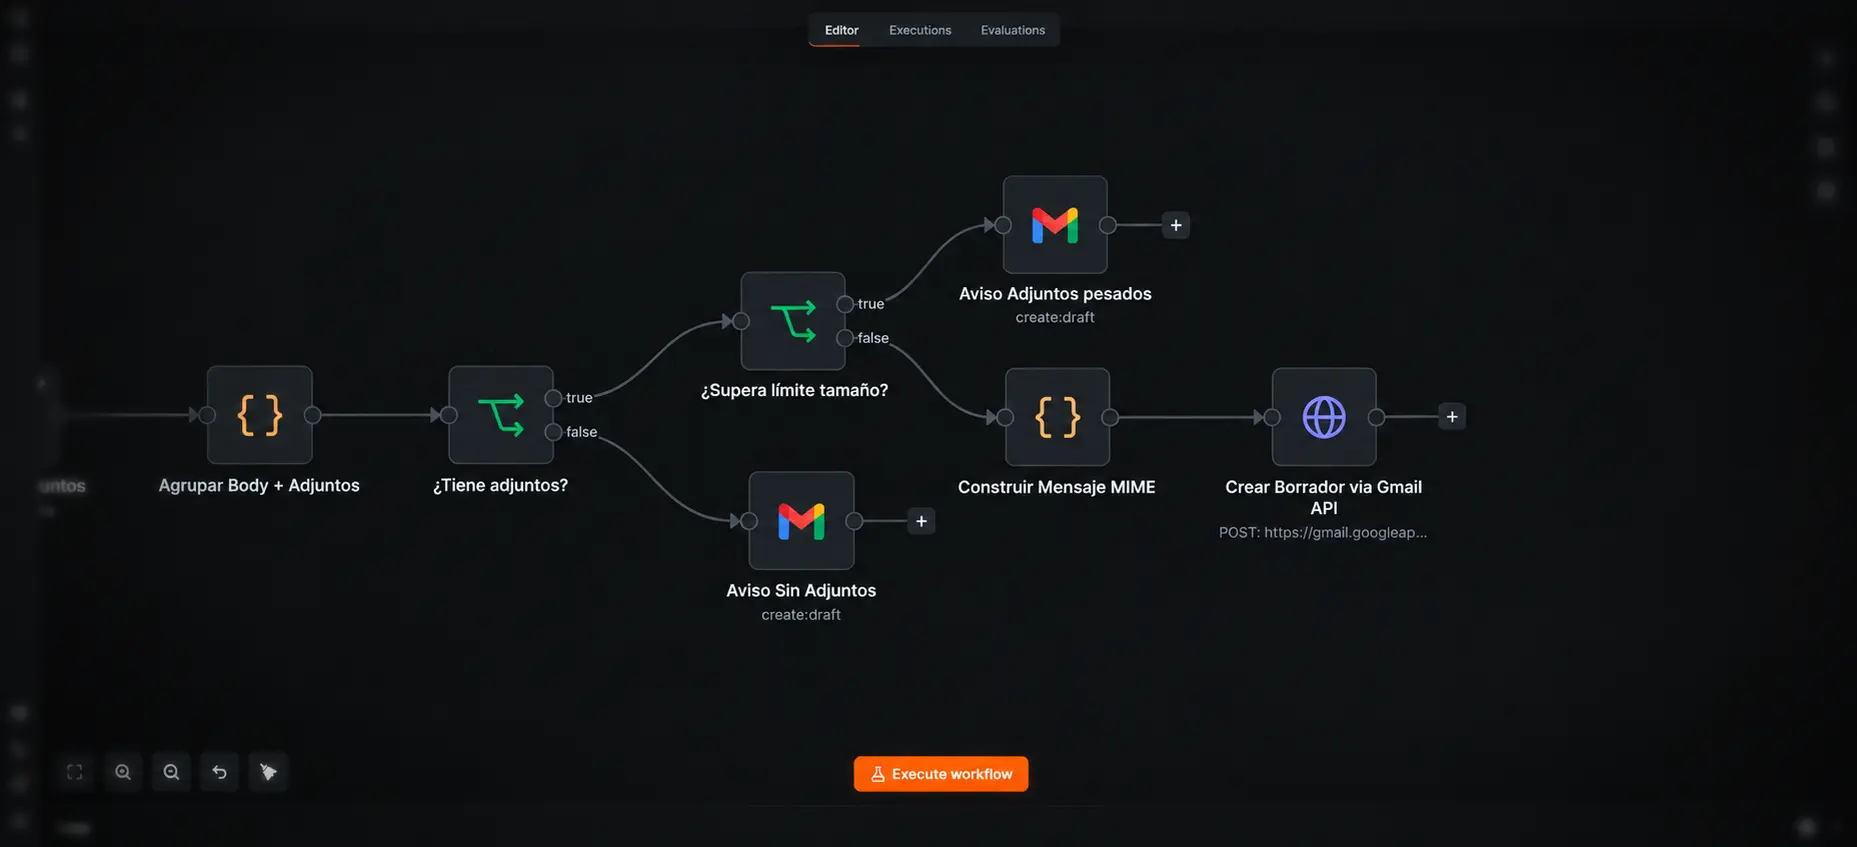
El flujo de condiciones comerciales tenía que generar un borrador en Gmail con su firma, sus imágenes y la tarifa adjunta. El nodo nativo de Gmail crea borradores, pero no permite incrustar imágenes en el cuerpo del mensaje.
La solución fue construir el mensaje MIME a mano en un nodo de código y enviarlo a la API de Gmail con un HTTP Request. Un multipart/mixed para los adjuntos que envuelve a un multipart/related con el HTML y las imágenes referenciadas por cid:. De paso hubo que limpiar el HTML que exporta Google Docs y convertir sus imágenes en base64 en partes inline del mensaje.
El mismo patrón apareció en otro flujo, este de sincronización entre un CRM y Mailchimp. El nodo nativo daba de alta al contacto sin problema, pero no permitía algo tan concreto como añadirle etiquetas. Otra vez HTTP Request contra la API.
No lo cuento como queja. Al contrario: es justo lo que hace que n8n aguante casos reales. Pero conviene saberlo antes de comprometer un plazo, porque el 80% del flujo lo montas en una tarde y el 20% restante se puede llevar un día entero.
3. A veces el problema no es el prompt, es el modelo
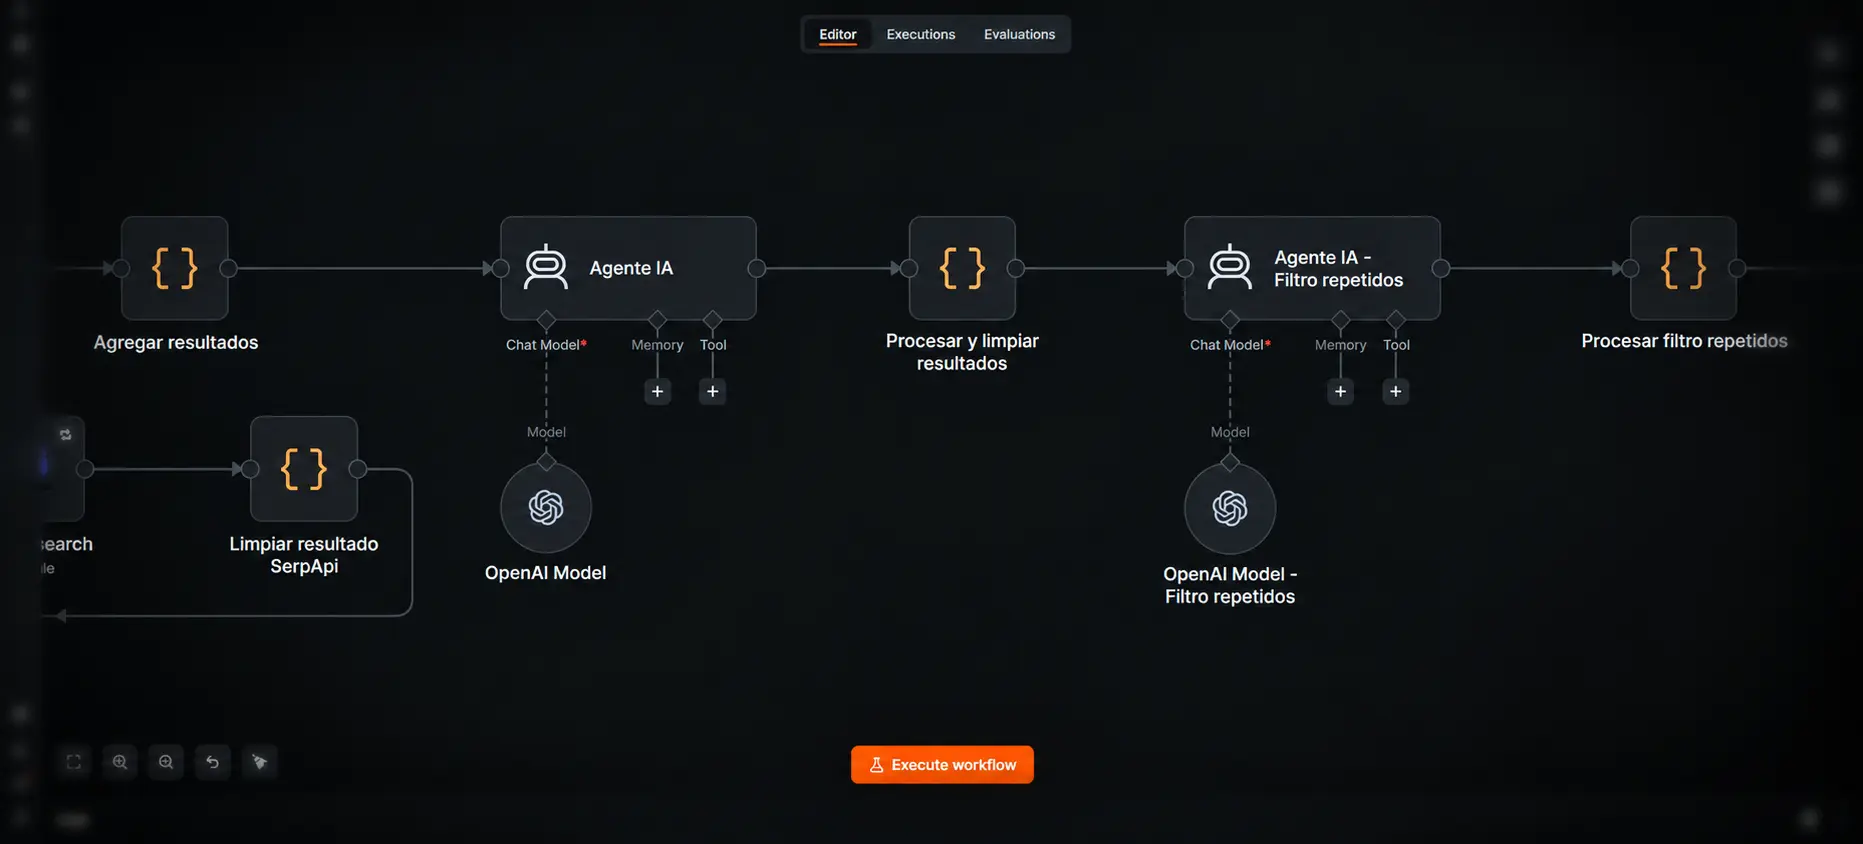
El flujo que más me ha enseñado sobre cómo se comporta la IA es el del resumen de noticias que mencionaba al principio. Cada mañana busca en una veintena de medios financieros las publicaciones del último día que contienen ciertos términos: hipotecas, depósitos, comisiones, Bizum… Esa búsqueda devuelve decenas de resultados y la mayoría no interesan: cotizaciones bursátiles, artículos de opinión, noticias de otros países o la misma noticia publicada en cinco medios. Separar lo relevante del ruido es trabajo de la IA, y de ahí salen esta lección y las tres siguientes.
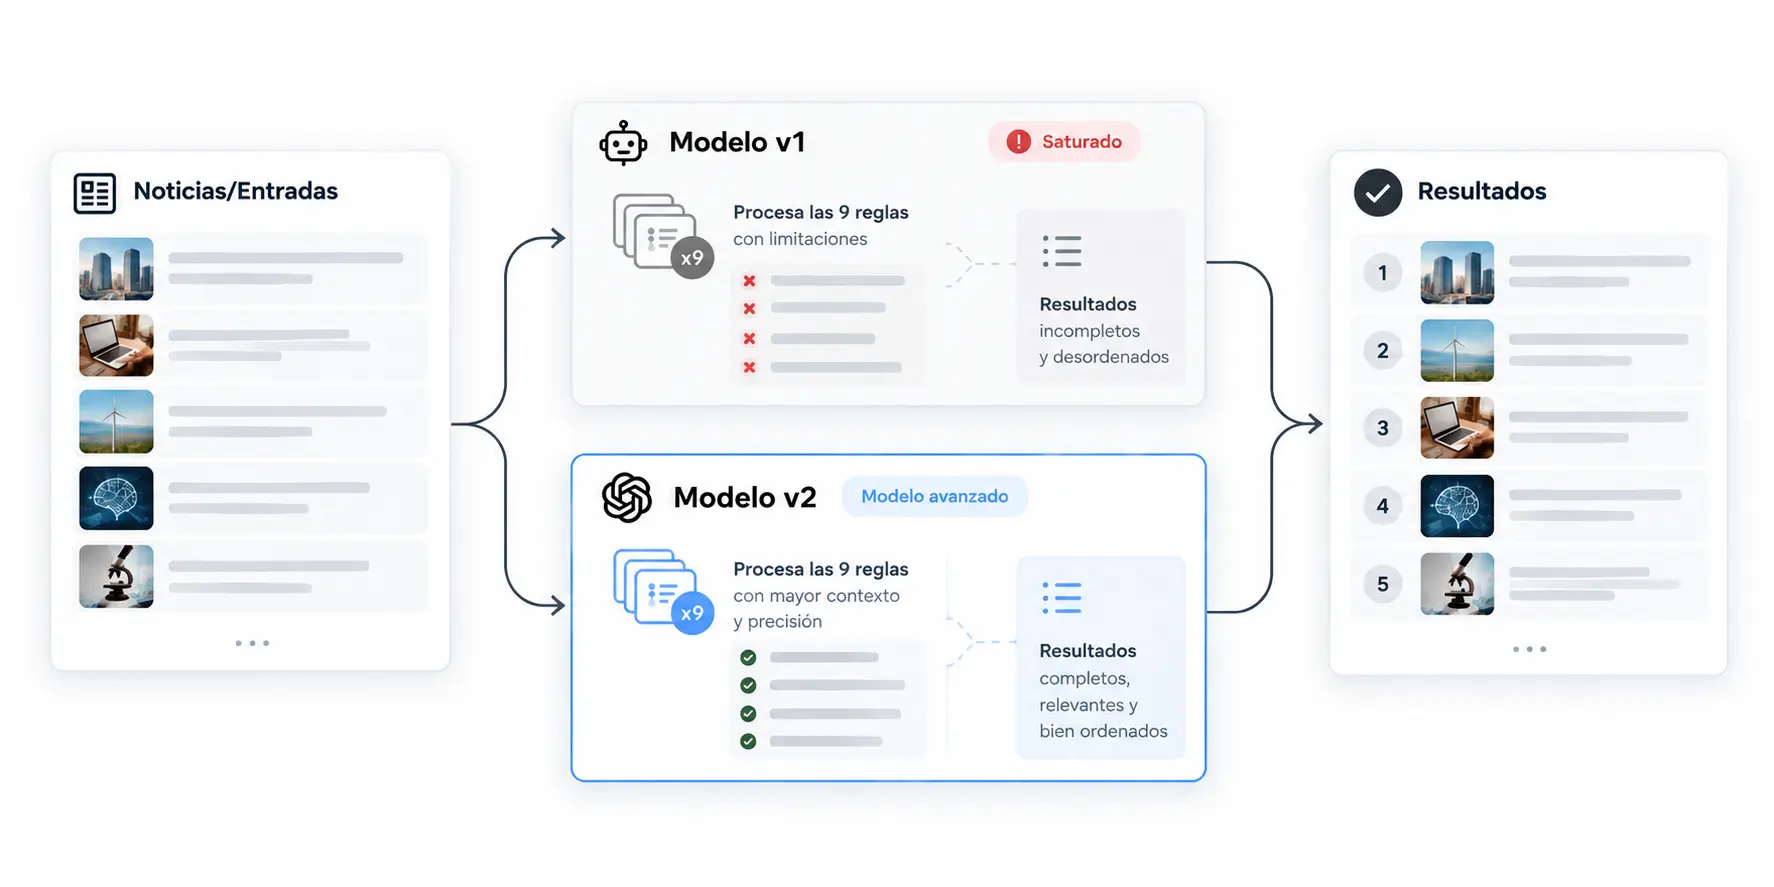
Para ese filtrado, el agente de IA tiene un criterio editorial largo: nueve grupos de aceptación, una lista de descartes, una regla de desempate y ejemplos reales de noticias que sí entraron y de otras que no.
Empecé con modelos más baratos, porque cuando montas algo que se ejecuta a diario siempre buscas ajustar el coste. Y no funcionaba. Se colaban noticias que incumplían reglas explícitas, incluso reglas que tenían su propio ejemplo justo al lado. Añadí más ejemplos, reescribí las normas, las reordené. El resultado no mejoraba.
Ahí está la lección. Cuando el prompt ya describe la regla con claridad y el modelo se la sigue saltando, seguir afinando el prompt es contraproducente. El problema no es de redacción, es de capacidad para sostener muchas reglas a la vez. Solamente subí a una versión un poco mejor y el comportamiento cambió de golpe.
La diferencia de coste entre un modelo y otro, en un flujo que se ejecuta una vez al día, es pequeña. El coste de revisar a mano un correo que se cuela a diario es mucho mayor.
4. Un agente, una responsabilidad
El filtrado no lo hace un solo agente. Hay dos.
El primero aplica el criterio editorial y decide si una noticia es relevante. El segundo solo hace dos cosas: detectar duplicados y comprobar que el impacto es en España. Y en su system message hay una frase que resultó clave: no le corresponde revisar la relevancia, esa decisión ya está tomada.
Sin esa acotación, el segundo agente volvía a hacer de editor y descartaba noticias que el primero había aceptado con buen criterio. Al darle un trabajo concreto y decirle explícitamente qué no es asunto suyo, deja de improvisar.
Hay una segunda pieza en ese mismo agente. Al principio devolvía únicamente las noticias que sobrevivían al filtro, que es lo natural: si descarta una, no la incluye. El problema es que un descarte, visto así, es una ausencia. Y las ausencias se olvidan. De vez en cuando dejaba pasar duplicados evidentes, no porque no los detectara, sino porque el formato de salida no le obligaba a pronunciarse sobre cada elemento.
Lo cambié para que devuelva una entrada por cada noticia recibida, con una decisión explícita:
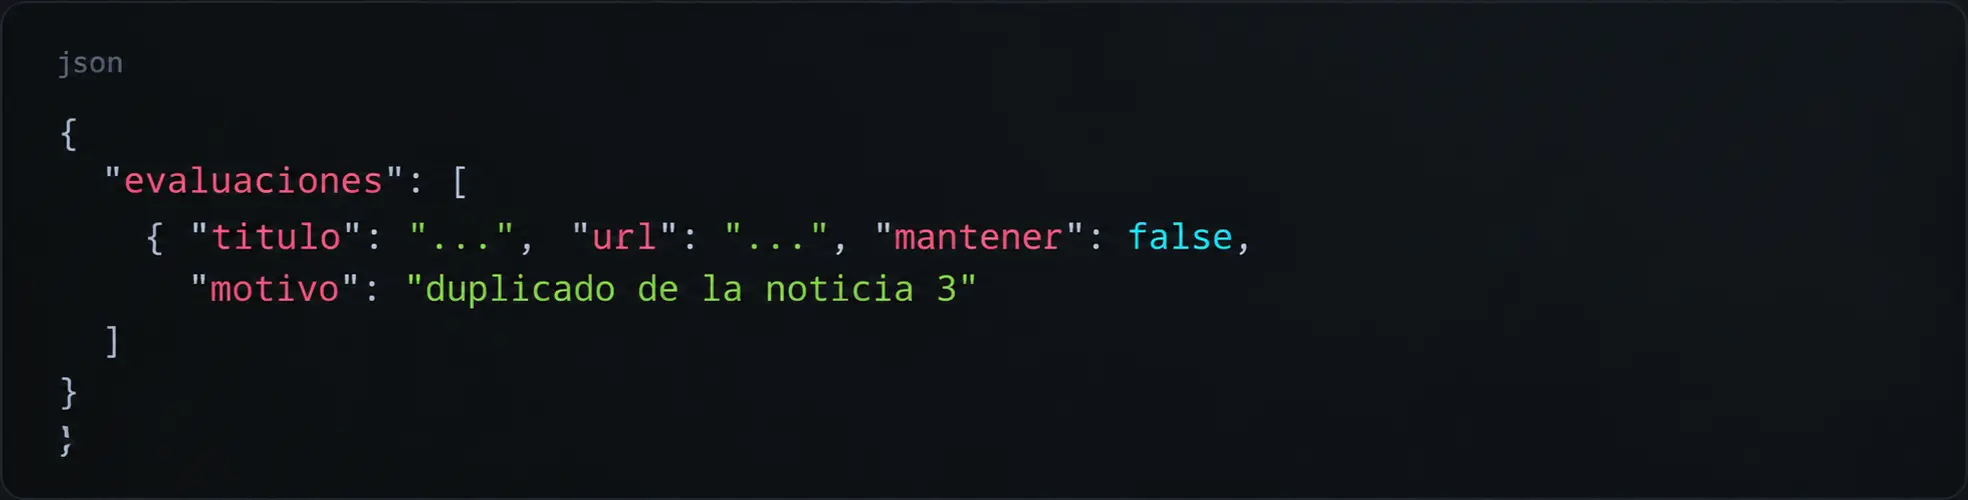
El filtrado real lo hace después un nodo de código con mantener !== true. El modelo no elimina nada, solo opina sobre todo. Y opinar sobre todo se le da mucho mejor que acordarse de omitir.
5. Pedirle que se justifique cambia la respuesta
En el primer agente hay una restricción que resultó más potente de lo que esperaba. Cada noticia aceptada tiene que venir acompañada de un campo motivo: una frase corta, de veinte palabras como máximo, que explique por qué esa noticia es relevante. Por ejemplo, "un banco sube la remuneración de su cuenta nómina". Y la instrucción añade que si no puede escribir ese motivo, descarte la noticia en lugar de forzarlo.
Lo interesante es que tiene dos efectos distintos. El obvio es el filtro final: lo que no se puede justificar se cae. El menos obvio, y el que más mejoró el resultado, es que obligar al modelo a explicarse le hace razonar antes de decidir. No está eligiendo y luego redactando una excusa; está construyendo el argumento mientras decide, y eso cambia la decisión misma.
Pedir "justifica tu respuesta" suena a detalle menor, casi cosmético. En la práctica fue uno de los cambios que más precisión aportó, y sale prácticamente gratis.
6. La IA no es la fuente de verdad
Aun con todo lo anterior, el modelo seguía emparejando de vez en cuando el titular de una noticia con la URL de otra. Y aquí hay un matiz importante: la URL existía de verdad en la lista original. Comprobar que la URL era válida no detectaba nada.
La red de seguridad final es un nodo de código que no se fía de nada de lo que devuelve el modelo salvo de su decisión. Busca cada URL en la lista original de resultados, descarta las que no aparecen y sustituye el título que ha escrito la IA por el título original asociado a esa URL. Así, aunque el modelo se equivoque al emparejar, el error nunca llega al correo.
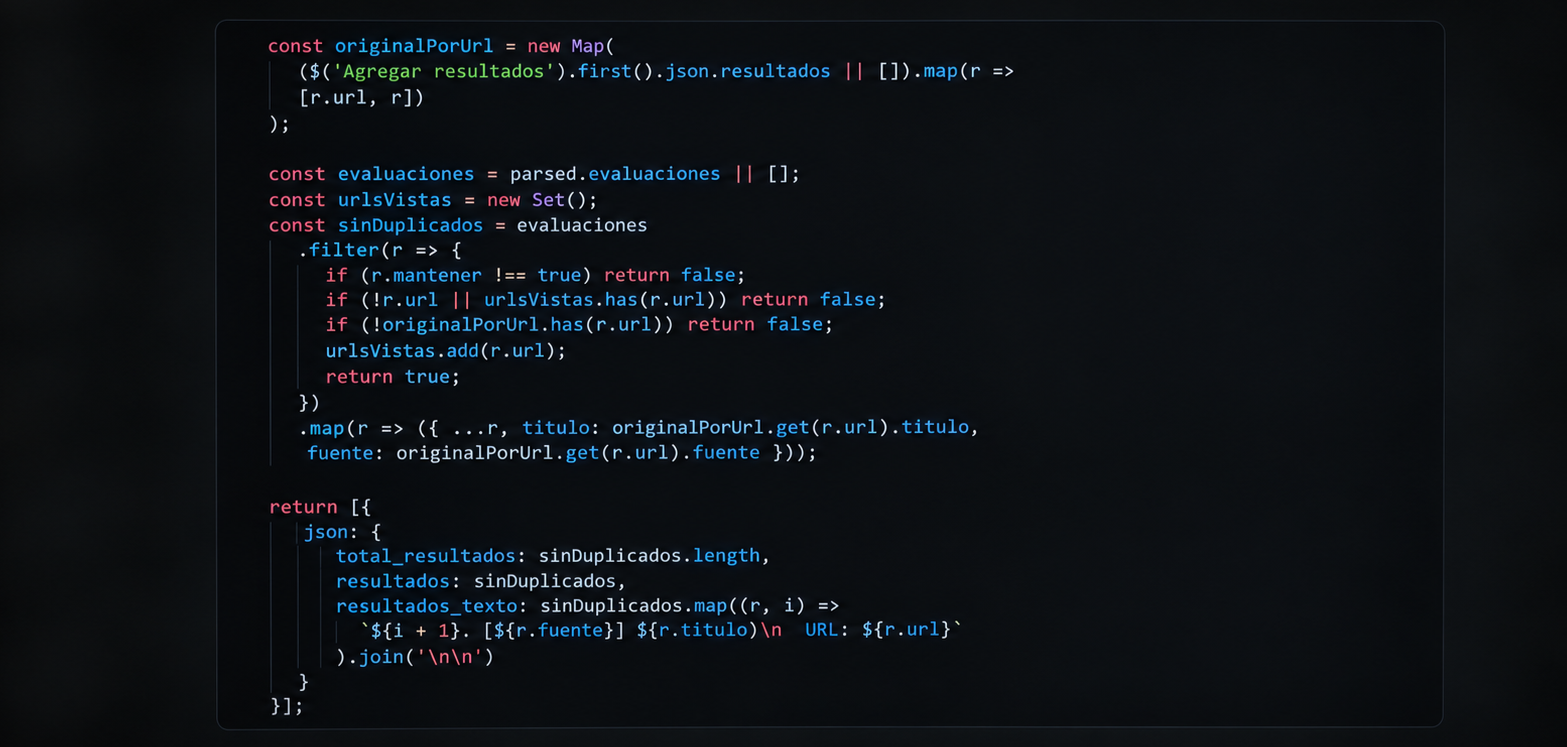
Nodo de validación: cada noticia se contrasta con la lista original por su URL
La idea de fondo vale para casi cualquier automatización con IA. El modelo clasifica, filtra o redacta, pero el dato que llega al destinatario sale siempre de la fuente original.
Al final, todo este trabajo se traduce en algo muy sencillo para quien lo recibe: un correo cada mañana con las noticias que importan, numeradas y enlazadas a su fuente. Si uno de esos titulares no se correspondiera con su enlace, daría igual lo bien que funcione el resto.
7. En un RAG, lo difícil es el texto
El último caso es un chatbot de soporte técnico para un fabricante de maquinaria. Responde dudas sobre el producto que el usuario está viendo y consulta una base vectorial para incidencias y averías.
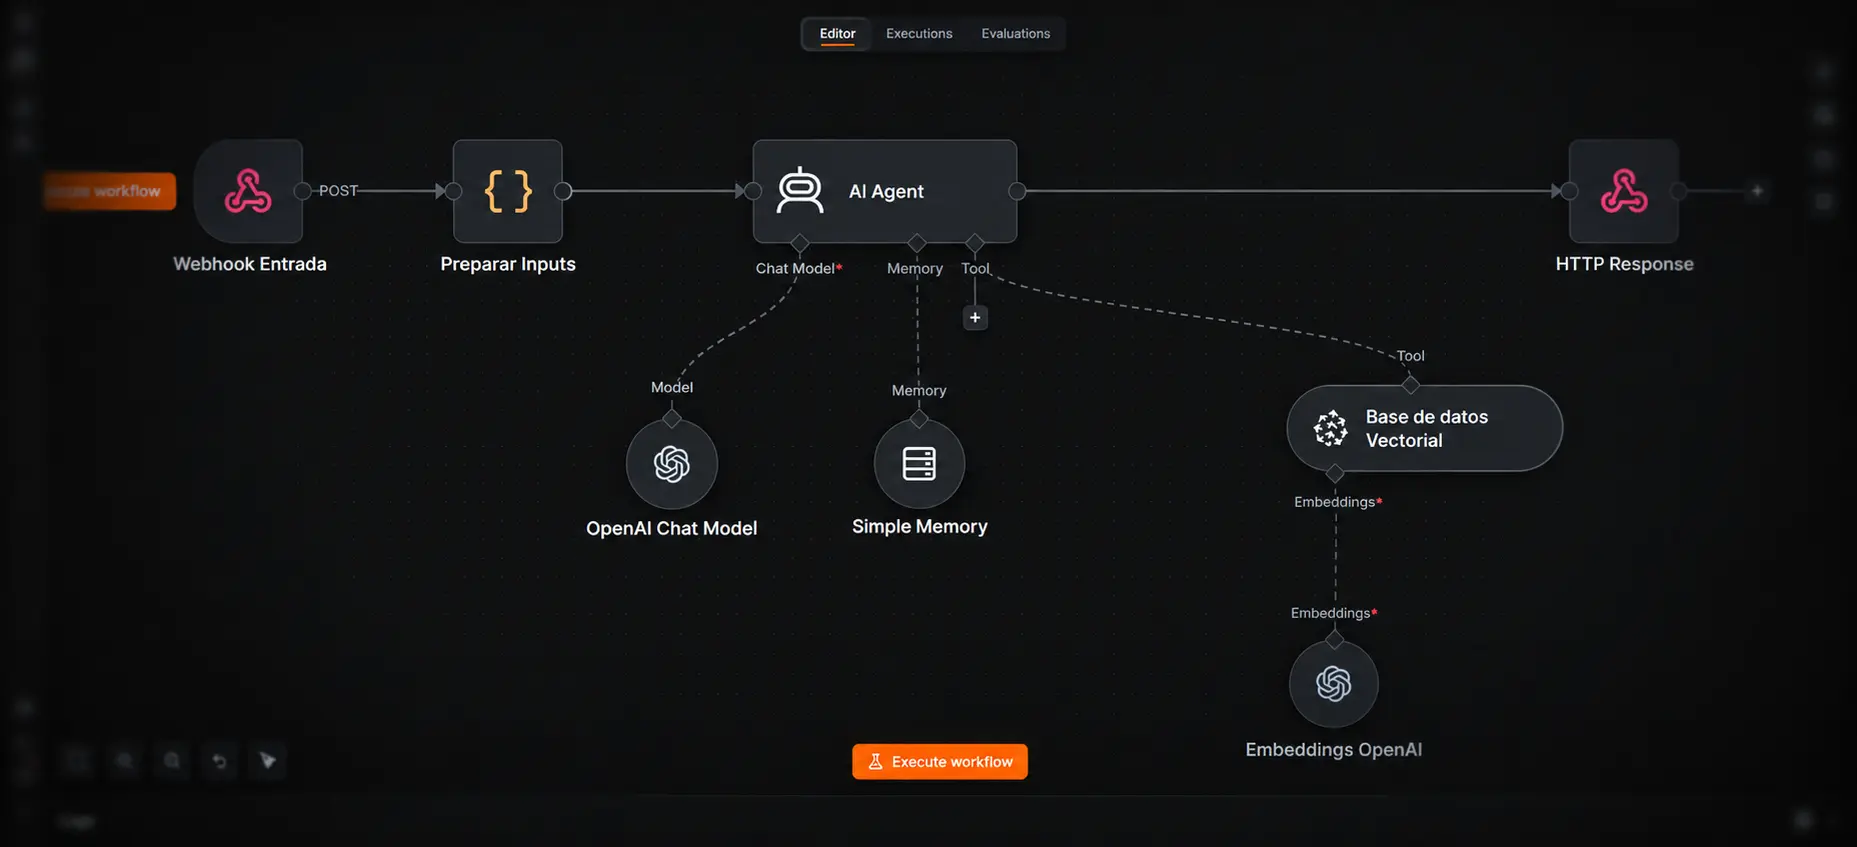
Montar el chatbot es lo rápido: un agente, un modelo, la base vectorial conectada como herramienta y memoria por sesión. Lo laborioso es lo que hay antes, y tiene más piezas que encajar de lo que parece.
La primera es la propia base vectorial. Cada índice se crea con un número fijo de dimensiones, y ese número tiene que coincidir exactamente con el del modelo de embeddings que convierte el texto en vectores. El modelo multilingüe ligero que usé al principio, de Hugging Face, genera vectores de 384 dimensiones; text-embedding-3-small de OpenAI, de 1.536. No son intercambiables: si cambias de modelo, tienes que crear un índice nuevo y volver a cargar todos los documentos. Conviene decidir el modelo de embeddings pronto, porque cambiarlo después obliga a rehacer toda la carga.
La segunda es el tamaño de cada fragmento. Los documentos no se guardan enteros, sino troceados en chunks de tamaño limitado, y cada uno se convierte en un vector independiente. Cuando el usuario pregunta, el agente solo recupera los fragmentos más parecidos a su pregunta. Si una incidencia quedó partida en dos chunks, puede recuperar el síntoma sin la solución, o la solución de otra avería.
Y aquí está la tercera pieza, la que une las dos anteriores: el texto de partida. Las fichas técnicas y los partes de servicio eran PDFs pensados para leerse, no para que los consuma una IA. Por eso hay un paso previo en el que un modelo los reescribe con un formato fijo: una entrada por incidencia o por producto, con una extensión acotada y encabezados marcados con ###. En la ingesta, el splitter corta exactamente por ese separador.
Es decir, diseñé la salida del preprocesado pensando en cómo iba a trocearla la ingesta y en qué tamaño iba a tener cada fragmento en la base vectorial. Así cada chunk es una unidad con sentido completo, con su síntoma, su causa y su solución, y no media incidencia cortada por la mitad.
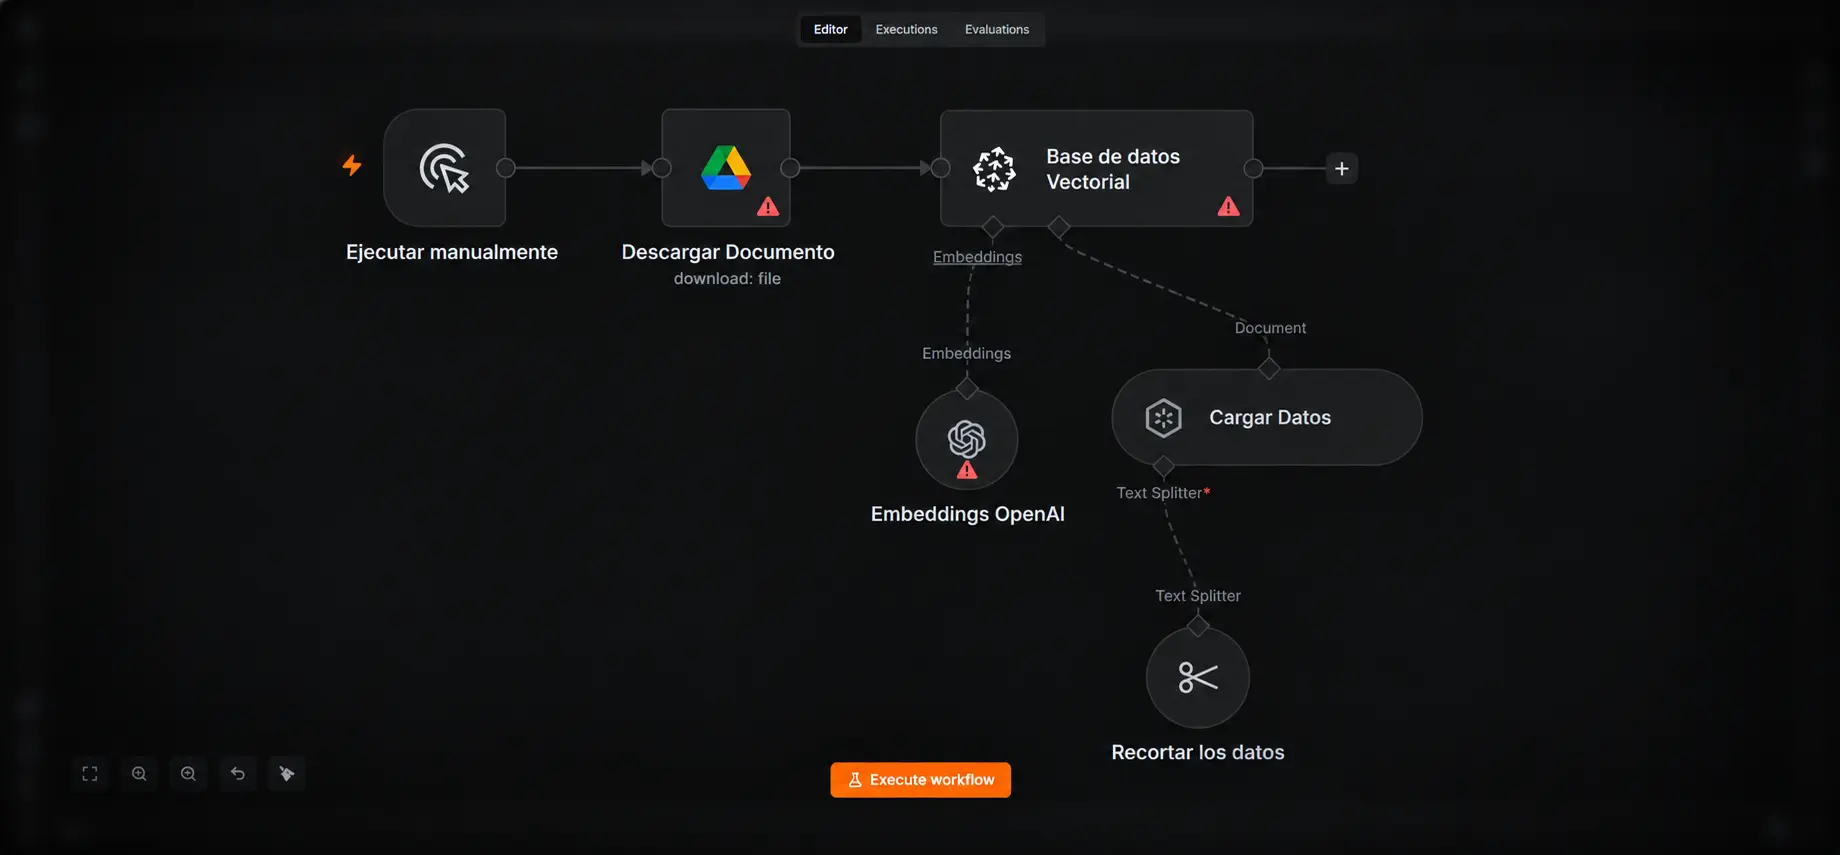
Empecé esta parte con modelos gratuitos para ver cómo se comportaba el conjunto. Cuando tuve claro que el planteamiento funcionaba y tocaba afinar calidad, cambié a modelos de pago. Prototipar gratis y ajustar después es un buen orden, siempre que tengas presente lo anterior: al cambiar el modelo de embeddings, la base vectorial se rehace.
Conclusión
Si algo tienen en común estas siete lecciones es que ninguna trata de n8n en sí. La herramienta se aprende rápido y cumple lo que promete. Lo que separa un flujo con IA que funciona en una demo de uno que funciona cada mañana es cómo se reparte el trabajo entre el modelo y el resto del flujo: qué decide la IA, qué comprueba el código y qué datos no se tocan.
En la práctica, eso significa tratar al modelo como una pieza más. Con una tarea acotada, obligado a justificar lo que hace y sin la última palabra sobre los datos que llegan al usuario.
Esos 45 minutos de revisión de prensa no desaparecieron el día que conectamos una IA a un buscador. Desaparecieron varias iteraciones después, ajustando criterios, cazando casos raros y poniendo redes de seguridad donde hacían falta. Ese trabajo no se ve en el correo que llega cada mañana, pero es lo que hace que funcione.
Solutions Engineer especializado en inteligencia artificial, automatización de procesos e integración de sistemas empresariales. Participa en el diseño y desarrollo de soluciones que combinan IA y programación a medida para optimizar procesos y conectar herramientas corporativas. Su trabajo se centra en transformar las posibilidades de la inteligencia artificial en soluciones fiables, escalables y aplicables a las necesidades reales de las empresas.


