ChatGPT, Claude o Gemini: qué IA elegir para tu empresa


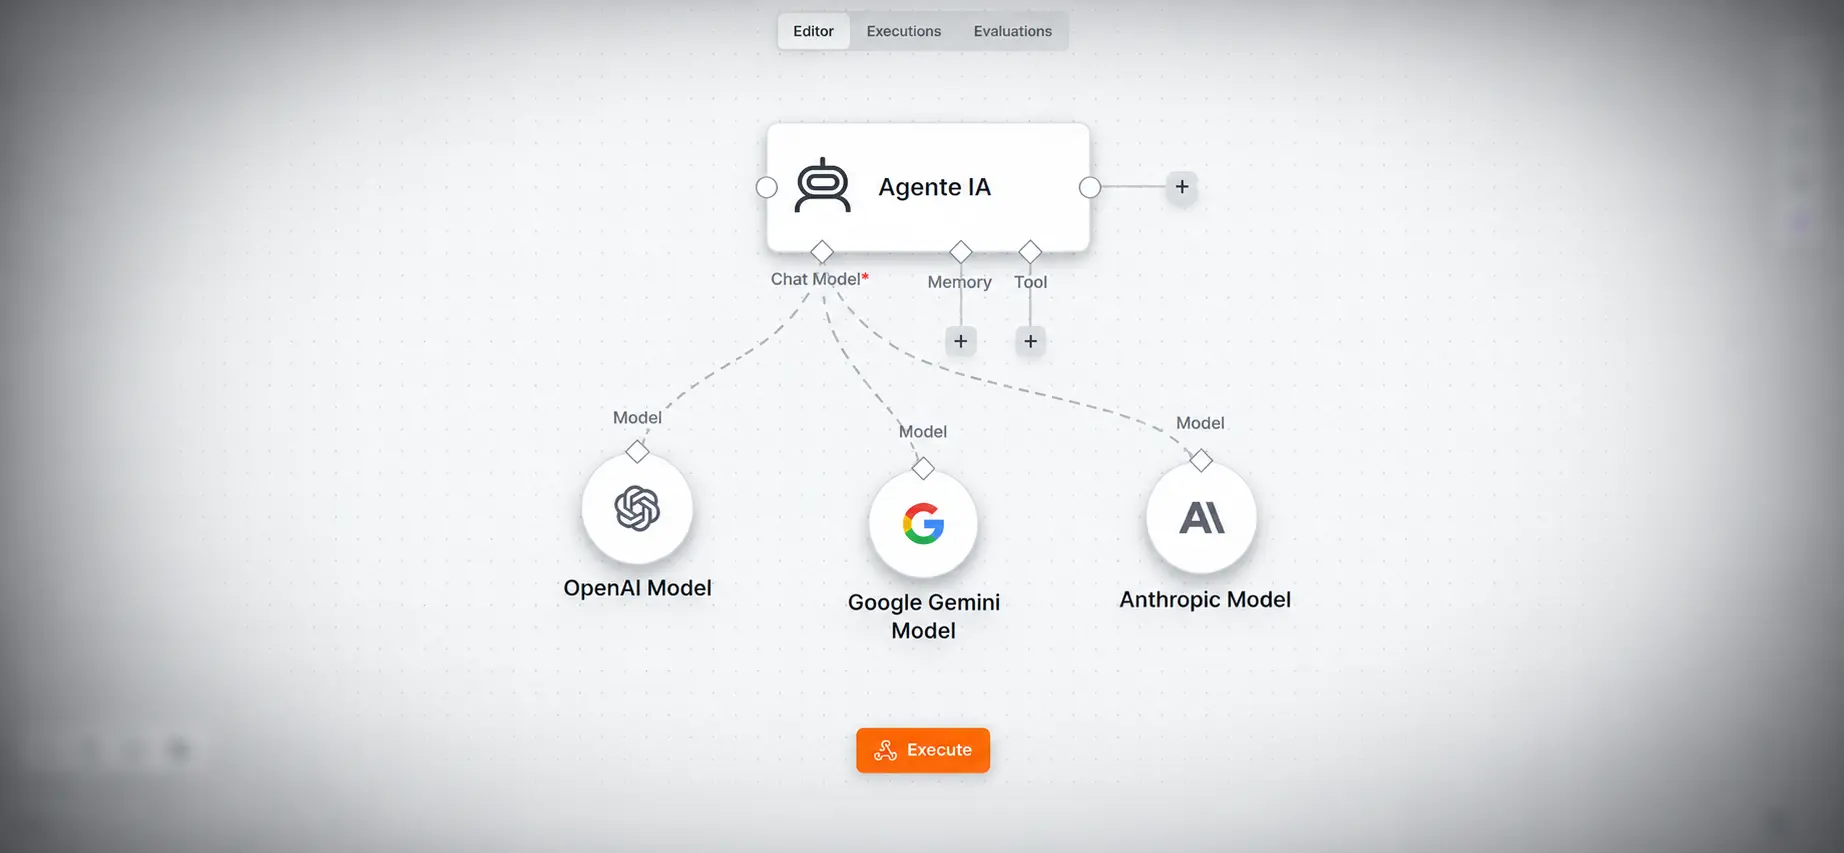
En uno de nuestros proyectos, un flujo que filtra cada mañana las noticias relevantes del sector financiero, estabamos usando un modelo económico. Las reglas estaban bien escritas, pero se colaban noticias que debían descartarse. Reescribir las instrucciones no lo arregló. Pasar a un modelo un escalón superior, sí. La diferencia de coste era pequeña. Revisar errores a mano cada día habría salido mucho más caro.
Esa es la idea de fondo. Entre GPT, Claude, Gemini y el resto no hay un ganador absoluto. Hay un modelo adecuado para cada proceso, una forma de usarlo que protege tus datos y una arquitectura que te permite cambiar cuando llegue el siguiente.
Los principales proveedores, en breve
Hoy cuatro proveedores y un puñado de modelos abiertos cubren casi cualquier necesidad empresarial. Los grandes ofrecen varias gamas, con un modelo tope para tareas difíciles, uno intermedio para el día a día y uno pequeño, rápido y barato. Elegir la gama dentro de un proveedor importa tanto como elegir el proveedor.
| Proveedor | Gamas actuales | Rasgo diferencial |
|---|---|---|
| OpenAI (GPT) | GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna | Tres gamas de precio bien diferenciadas y un amplio catálogo de modelos de voz, imagen y transcripción |
| Anthropic (Claude) | Fable 5.1, Opus 5.5, Sonnet 5.5 y Haiku 5.5 | Muy sólido en programación y en tareas largas con muchas instrucciones |
| Google (Gemini) | Gemini 3.8 Flash y Flash-Lite, con 3.1 Pro en vista previa | Su gama Flash combina velocidad y bajo coste, y tiene un catálogo muy completo de voz, imagen y vídeo |
| Mistral | Medium 3.5 y Small 4, con Large 4 en vista previa | Empresa europea que permite procesar los datos dentro de la UE y ofrece modelos con pesos abiertos |
| Modelos abiertos (Llama, Gemma, Qwen, DeepSeek…) | Varios tamaños | Se pueden ejecutar en infraestructura propia |
Gamas disponibles a octubre de 2026, según la documentación oficial de OpenAI, Anthropic, Google y Mistral. El procesamiento en la UE de Mistral se explica en su página de inferencia regional.
En nuestro día a día usamos más de uno. El filtrado de noticias funciona con un modelo GPT de OpenAI, y para programar trabajamos con Claude Opus a través de Claude Code. No es indecisión. Cada tarea tiene un modelo que la resuelve mejor.
Las versiones concretas cambian cada pocos meses, así que es probable que cuando leas esto alguno de estos nombres ya se haya quedado antiguo.
Cuatro formas de usar un modelo y dónde acaban tus datos
El mismo modelo puede ser seguro o arriesgado según cómo se use. Antes de comparar proveedores, conviene decidir por qué vía vas a acceder a ellos.
| Vía | Ejemplo | ¿Entrenan con tus datos? | Dónde se procesan | Encaja para |
|---|---|---|---|---|
| App en plan personal | ChatGPT, Gemini o Claude con cuenta individual | Depende del proveedor. OpenAI lo hace por defecto, salvo que lo desactives | Servidores del proveedor | Uso individual sin datos sensibles |
| App en plan de empresa | ChatGPT Business o Enterprise y equivalentes | No por defecto, y se puede firmar un contrato de tratamiento de datos (RGPD) | Servidores del proveedor | Productividad de los equipos |
| API del proveedor | Un flujo de n8n que llama a OpenAI | No por defecto, aunque se guardan hasta 30 días para control de abusos | Servidores del proveedor, aunque algunos ofrecen procesamiento en la UE con recargo | Automatizaciones e integraciones |
| Modelo dentro de tu nube | Amazon Bedrock en tu cuenta de AWS | No, y no se comparten con el fabricante del modelo | La región de AWS que elijas | Datos sensibles y sistemas críticos |
Datos a octubre de 2026, según las políticas de datos de OpenAI para particulares, empresas y API, y las preguntas frecuentes de Amazon Bedrock.
La primera fila es la que más riesgos genera. Basta con que un empleado use su cuenta personal de ChatGPT para resumir un contrato de un cliente. Ese documento sale de la empresa sin control y, según el proveedor, puede usarse para entrenar el modelo. Las otras tres vías son aptas para empresa, y la diferencia entre ellas es de control.
La cuarta vía es la más recomendable cuando hay información sensible. Amazon Bedrock reúne modelos de más de una decena de proveedores, entre ellos Anthropic, OpenAI, Meta, Mistral, DeepSeek y los propios de Amazon. Un matiz importante es que no todos los modelos están en todas las regiones. Por ejemplo, Gemma 4 está disponible en Fráncfort, mientras que GPT-5.6 llegó a Bedrock en julio de 2026 solo en regiones de EE. UU. Si necesitas que los datos se queden en Europa, la región reduce el catálogo. Y conviene revisar que no esté activada la inferencia entre regiones, que puede procesar las peticiones fuera de la región elegida.
Hay una quinta opción, que es descargar un modelo de pesos abiertos y ejecutarlo en tus propios servidores. Da el máximo control, pero también trae el coste de mantener esa infraestructura.
Qué gama de modelo para cada tarea
Como regla general, la gama pequeña basta para tareas simples y repetitivas. Cuantas más reglas tiene que respetar el modelo a la vez, más sube la gama necesaria.
| Tarea | Ejemplo | Gama | Por qué |
|---|---|---|---|
| Clasificar y extraer datos | Leer facturas, ordenar correos entrantes, etiquetar incidencias | Pequeña | Mucho volumen y reglas sencillas, así que manda el precio |
| Redactar a partir de una plantilla | Respuestas a clientes, propuestas comerciales, correos de seguimiento | Intermedia | El tono y la precisión importan, y una persona suele revisar antes de enviar |
| Decidir con muchos criterios a la vez | Seleccionar noticias relevantes, revisar documentos según normas internas | Intermedia o tope | Los modelos pequeños empiezan a saltarse reglas cuando son muchas |
| Responder con la documentación propia | Asistente interno, soporte técnico a clientes | Intermedia | El resultado depende más de cómo se prepara la documentación que del modelo |
| Encadenar pasos en otros sistemas | Un agente que consulta el CRM, prepara un presupuesto y lo deja listo en el correo | Tope | Un error en un paso se arrastra a todos los siguientes |
En nuestros proyectos lo hemos visto claro. En el asistente de soporte para un fabricante de maquinaria, lo que marcó la diferencia fue cómo se preparó la documentación técnica, no el modelo elegido.
Nuestra forma de trabajar es prototipar con modelos gratuitos o baratos y, cuando el planteamiento funciona, ajustar la gama a la calidad que pide el proceso.
El modelo barato no siempre sale más barato
El coste de un modelo se mide por la cantidad de texto que procesa, y la diferencia entre gamas es enorme. En OpenAI, por ejemplo, el modelo tope cuesta unas cien veces más que el más económico. Aun así, en un proceso que se ejecuta una vez al día esa diferencia tiene poco peso en el coste total. Lo realmente caro es que alguien tenga que revisar a mano lo que la IA hizo mal.
Antes de decidir por precio conviene hacer tres cuentas.
- Volumen. Miles de ejecuciones diarias justifican apretar el coste por unidad. Una al día, casi nunca.
- Coste del error. Un informe con datos equivocados, un presupuesto mal redactado o una respuesta incorrecta a un cliente cuestan más que cualquier ahorro en el modelo.
- Descuentos de uso. Los procesos que no necesitan respuesta inmediata pueden ejecutarse por lotes, y en Bedrock eso rebaja un 50% el precio de varios modelos. Además, cuando cada llamada repite el mismo contexto, la caché puede abaratar esa parte hasta un 90% en algunos modelos.
Dicho de otra forma, el ahorro hay que buscarlo en cómo se usa el modelo, no solo en cuál se elige.
No te cases con un modelo
El modelo que elijas hoy no será el que uses dentro de dos años, y no siempre por decisión tuya. Los proveedores retiran versiones antiguas con regularidad. OpenAI, por ejemplo, garantiza al menos seis meses de aviso antes de retirar uno de sus modelos principales, y programó para el 23 de octubre de 2026 la retirada de una docena de versiones anteriores.
Por eso lo que de verdad hay que diseñar bien es la arquitectura alrededor del modelo.
- Una capa que conecte con varios proveedores. Con herramientas como n8n o servicios como Amazon Bedrock, cambiar de modelo es cambiar una configuración, no rehacer el proyecto.
- El criterio de negocio, separado del modelo. Las reglas de qué se acepta y qué se descarta se escriben una vez y se pueden probar con cualquier modelo.
- Validación fuera de la IA. Si los datos que llegan al usuario se contrastan siempre con la fuente original, es mucho más difícil que un cambio de modelo cuele errores.
- Un banco de pruebas con casos reales. Unos cuantos ejemplos de lo que debe salir bien y de lo que debe descartarse permiten comparar un modelo nuevo con el actual en muy poco tiempo.
Así, cuando aparece un modelo mejor o más barato, cambiar es cuestión de probarlo con esos casos y decidir.
Seis preguntas antes de elegir
Si vas a poner IA en un proceso de tu empresa, estas preguntas te ayudarán a ordenar la decisión.
- ¿Qué proceso concreto quiero mejorar y cuánto tiempo consume hoy? Sin una cifra de partida no podrás medir el resultado.
- ¿Qué datos va a ver la IA? Si son personales, financieros o confidenciales, decide primero dónde se procesan.
- ¿Cuántas reglas tiene que respetar a la vez? Si son pocas y claras, basta con una gama pequeña. Si son muchas y con excepciones, necesitarás una gama intermedia o tope.
- ¿Cuánto cuesta un error? Si es alto, prioriza la calidad y añade validaciones fuera del modelo.
- ¿Con qué sistemas tiene que conectarse? ERP, CRM, correo, documentación. La integración suele llevar más trabajo que el modelo.
- ¿Qué pasa si mañana tengo que cambiar de modelo? Si la respuesta es rehacerlo todo, la arquitectura no está bien planteada.
Preguntas frecuentes sobre modelos de IA para empresas
No hay uno solo. Depende de la tarea, del volumen y de la sensibilidad de los datos. Lo habitual es combinar varios, uno potente para lo complejo y otro económico para lo repetitivo.
Los tres ofrecen varias gamas de precio y capacidad, y para la mayoría de tareas de empresa cualquiera de ellos funciona bien. OpenAI destaca por su amplio catálogo de modelos de voz, imagen y transcripción. Claude es especialmente sólido en programación y en tareas largas con muchas instrucciones. Gemini sobresale en su gama Flash, que combina velocidad y bajo coste. La elección depende más de la tarea concreta que del proveedor.
Depende del plan. En las cuentas para particulares (Free, Plus y Pro), OpenAI puede usar las conversaciones para entrenar sus modelos si no se desactiva esa opción en los ajustes. En los planes de empresa y en la API no lo hace por defecto, y además se puede firmar un contrato de tratamiento de datos conforme al RGPD.
Sí. En Amazon Bedrock los datos se almacenan en la región de AWS que elijas, aunque no todos los modelos están disponibles en las regiones europeas y conviene no activar la inferencia entre regiones. Algunos proveedores también ofrecen procesamiento en la Unión Europea en su propia API. Mistral lo hace con un recargo del 10%, y OpenAI previa solicitud y aprobación, con un recargo similar en sus modelos recientes.
Depende de cuánto control necesites. Los modelos abiertos se pueden ejecutar en servidores propios, así que los datos nunca salen de la empresa, pero exigen mantener esa infraestructura. Los comerciales se usan sin gestionar servidores y llegan con las herramientas y el soporte del proveedor. Muchas empresas acaban combinando ambos según el proceso.
Al menos un par de veces al año, y siempre que el proveedor anuncie la retirada de una versión. OpenAI, por ejemplo, avisa con un mínimo de seis meses en sus modelos principales. Con una arquitectura que permita cambiar de modelo fácilmente, esa revisión se hace en poco tiempo.
Conclusión
Elegir modelo de IA se parece menos a escoger el mejor producto del mercado y más a asignar la herramienta adecuada a cada trabajo. Lo que marca la diferencia es decidir dónde se procesan los datos, ajustar la gama a cada tarea y construir una arquitectura que permita cambiar de modelo sin rehacer nada.
GPT, Claude y Gemini seguirán turnándose en lo alto de las comparativas. Lo que no cambia es la pregunta que hay que hacerse antes, qué necesita cada proceso. En Dreams, te ayudamos a elegir el modelo.
Solutions Engineer especializado en inteligencia artificial, automatización de procesos e integración de sistemas empresariales. Participa en el diseño y desarrollo de soluciones que combinan IA y programación a medida para optimizar procesos y conectar herramientas corporativas. Su trabajo se centra en transformar las posibilidades de la inteligencia artificial en soluciones fiables, escalables y aplicables a las necesidades reales de las empresas.


